

- Description
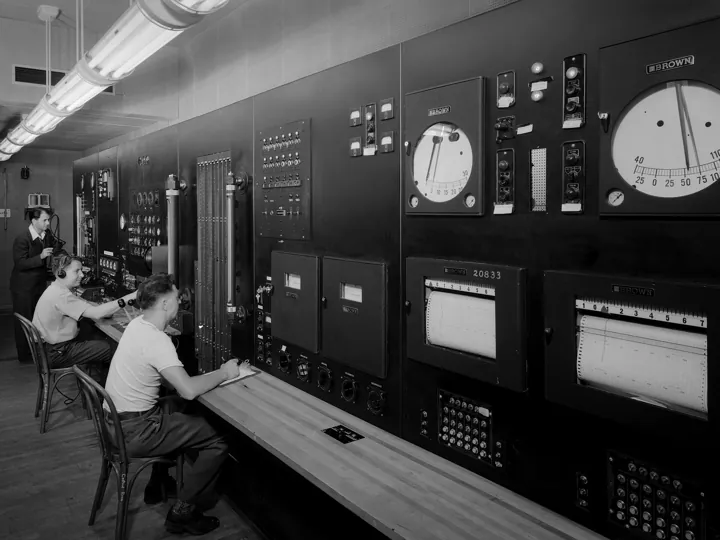
- Salle de contrôle d'une soufflerie : mur de cadrans, de voyants et d'enregistreurs à papier, surveillé par des opérateurs.
- Source
- NASA (Aircraft Engine Research Laboratory) · page d’origine
- Licence
- PD Domaine public
 Observabilité et fiabilité
Ce thème mesure la capacité à savoir ce que fait le logiciel en production, à détecter qu'il se dégrade avant ses utilisateurs, et à le rétablir vite. Les promesses s'expriment en délai de…
En bref
Ce thème mesure la capacité à savoir ce que fait le logiciel en production, à détecter qu'il se dégrade avant ses utilisateurs, et à le rétablir vite. Les promesses s'expriment en délai de détection, délai de rétablissement et en objectifs de niveau de service (SLO) chiffrés. La supervision des chaînes de données est détaillée côté BI 10 et Data 10.
Sur cette page
Niveau : 🟢→🔴 · Code thème : OBS (matrice DL)
Pourquoi ce thème#
« C'est l'utilisateur qui nous prévient » est le signe d'un angle mort. Chaque minute entre la panne et sa détection est une minute d'incident invisible, de décisions prises sur de mauvaises données, de confiance perdue. À l'inverse, la sur-alerte épuise : une équipe qui reçoit 200 alertes par jour n'en traite aucune. La fiabilité est donc un équilibre mesuré entre vitesse de changement et stabilité, que l'approche SRE (Site Reliability Engineering) formalise par les SLO et le budget d'erreur.
L'observabilité se distingue de la simple supervision : superviser, c'est vérifier des questions prévues (« le service répond-il ? ») ; observer, c'est pouvoir poser des questions imprévues à partir de signaux riches (journaux structurés, métriques, traces corrélées). Le standard ouvert OpenTelemetry fournit un vocabulaire commun pour ces signaux.
Dans un datamart, un traitement nocturne peut « réussir » techniquement avec des chiffres faux : la fiabilité inclut la fraîcheur et l'exactitude des données, pas seulement la disponibilité. Voir 08 BI — tests et fiabilité des chiffres.
Ce que mesure le thème#
- Axe : de « on découvre les pannes par les plaintes » à « les objectifs de service pilotent les décisions de changement ».
- Indicateurs clés : délai de détection (MTTD) ; délai de rétablissement ; part des incidents détectés par la supervision plutôt que par les utilisateurs ; respect des SLO ; bruit d'alerte (alertes non actionnables).
- Unité : minutes ; % ; alertes par semaine et par personne d'astreinte.
Tableau des cinq niveaux#
| Niveau | Nom court | Promesse | Indicateur type (ordre de grandeur) |
|---|---|---|---|
| 1 | Aveugle | Une panne est connue quand un utilisateur la signale. | Détection par les utilisateurs > 80 % |
| 2 | Surveillée | Les pannes franches (service arrêté, disque plein) sont détectées avant les utilisateurs. | Détection < 30 min sur pannes franches |
| 3 | Diagnostiquée | Face à un incident, on trouve la cause en quelques minutes grâce aux journaux et métriques corrélés. | Journaux structurés ; diagnostic < 1 h |
| 4 | Pilotée par objectifs | Des objectifs de service chiffrés existent ; quand le budget d'erreur est consommé, on ralentit les changements. | SLO par service ; alertes sur consommation de budget ; > 90 % d'alertes actionnables |
| 5 | Résiliente | Le système absorbe des pannes partielles sans impact visible, et chaque incident améliore le système. | Pannes contenues ; exercices de chaos ; apprentissage mesuré |
Jalons par niveau#
| ID | Jalon | Preuve vérifiable |
|---|---|---|
| DL-OBS-1.1 | Les erreurs applicatives sont journalisées quelque part consultable | Journal accessible à l'équipe |
| DL-OBS-1.2 | Les incidents sont consignés (date, impact, cause, action) | Registre des incidents |
| DL-OBS-1.3 | Une personne ou un canal est identifié pour recevoir un signalement | Point d'entrée connu |
| DL-OBS-2.1 | Des vérifications d'état automatiques couvrent disponibilité, espace disque, traitements planifiés | Alertes de test reçues |
| DL-OBS-2.2 | Les alertes arrivent à une personne identifiée (astreinte ou rôle) | Planning d'astreinte |
| DL-OBS-2.3 | Un traitement planifié qui ne s'est pas exécuté (ou pas terminé) déclenche une alerte | Test en arrêtant un traitement |
| DL-OBS-2.4 | Les alertes ont un support de traitement (que faire) | Fiches d'action pour les 10 alertes les plus fréquentes |
| DL-OBS-3.1 | Les journaux sont structurés, horodatés au même format et portent un identifiant de corrélation | Reconstitution d'une transaction de bout en bout |
| DL-OBS-3.2 | Des métriques de service (latence, taux d'erreur, saturation, trafic) sont disponibles | Tableau de bord par service |
| DL-OBS-3.3 | Les temps de détection et de rétablissement sont mesurés par incident | Moyenne et médiane sur 6 mois |
| DL-OBS-3.4 | Une analyse après incident est menée sans recherche de coupable pour les incidents majeurs | Comptes rendus datés avec actions |
| DL-OBS-3.5 | La fraîcheur et le volume des données produites sont surveillés (nombre de lignes, date de dernière mise à jour) | Alerte sur donnée périmée |
| DL-OBS-4.1 | Des SLI (indicateurs) et SLO (objectifs) chiffrés existent pour chaque service critique | Document validé par le métier |
| DL-OBS-4.2 | Le budget d'erreur est suivi ; sa consommation modifie le rythme des changements | Décision documentée de gel/relance |
| DL-OBS-4.3 | Les alertes portent sur les symptômes (impact utilisateur) plutôt que sur les causes isolées | Revue du catalogue d'alertes |
| DL-OBS-4.4 | > 90 % des alertes déclenchées sont actionnables (revue trimestrielle du bruit) | Taux mesuré |
| DL-OBS-4.5 | Les traces distribuées ou équivalents couvrent les parcours critiques | Trace complète d'un parcours |
| DL-OBS-5.1 | Les mécanismes de reprise (reprise automatique, files, idempotence) absorbent les pannes partielles | Test de panne d'une dépendance |
| DL-OBS-5.2 | Des exercices de panne programmés (chaos, journées de reprise) ont lieu au moins deux fois par an | Comptes rendus |
| DL-OBS-5.3 | Les actions issues des incidents sont closes dans un délai défini (> 80 % sous 30 jours) | Suivi des actions |
| DL-OBS-5.4 | Le coût de l'observabilité (volume de télémétrie) est piloté sans perdre de signal | Politique d'échantillonnage et de rétention |
Lecture détaillée par niveau#
🟢 Niveau 1 — Aveugle#
- Signes : « on a su par le client » ; journaux dans des fichiers que personne ne regarde.
- Gain : coût nul.
- Ne garantit pas : ni détection, ni apprentissage.
- Difficulté : 1/5 · Effort : 1/5.
🟢 Niveau 2 — Surveillée#
- Signes : vérifications d'état, alertes à un responsable, détection des traitements qui ne se sont pas exécutés (le silence est un signal : l'absence de succès doit être alarmée).
- Gain : les pannes franches ne passent plus la nuit.
- Ne garantit pas : le diagnostic ni la détection de dégradations subtiles.
- Difficulté : 2/5 · Effort : 2/5.
🟡 Niveau 3 — Diagnostiquée#
- Signes : journaux structurés avec identifiant de corrélation, métriques de service (les « quatre signaux dorés » : latence, trafic, erreurs, saturation), analyses après incident.
- Gain : le temps de diagnostic passe de jours à minutes ; la mémoire des incidents s'accumule.
- Ne garantit pas : que la priorité des alertes reflète l'impact métier.
- Difficulté : 3/5 · Effort : 3/5.
🔴 Niveau 4 — Pilotée par objectifs#
- Signes : par exemple, un SLO de 99,5 % de traitements nocturnes terminés avant 6 h sur 30 jours laisse un budget d'erreur d'environ 3,6 h (0,5 % de 720 h) — ordre de grandeur ; si le budget est consommé, la priorité bascule de la fonctionnalité vers la fiabilité. Les alertes parlent d'impact (« les rapports du matin ne seront pas prêts »), pas de causes isolées.
- Gain : un langage commun entre produit et exploitation, des arbitrages explicites.
- Ne garantit pas : que l'objectif soit le bon — un SLO se révise avec l'usage réel.
- Difficulté : 4/5 · Effort : 4/5.
🔴 Niveau 5 — Résiliente#
- Signes : les pannes partielles sont absorbées (reprises idempotentes, files tampon), les exercices de panne sont routiniers, les actions des incidents sont closes.
- Gain : le système et l'équipe apprennent plus vite que les pannes n'arrivent.
- Ne garantit pas : l'absence d'incident majeur ; il réduit l'impact et la durée.
- Difficulté : 5/5 · Effort : 5/5.
Atteinte partielle et notation#
Appliquez la règle de notation.
- 0,5 sur DL-OBS-3.1 : journaux structurés pour l'application, texte libre pour les scripts planifiés.
- 0,5 sur DL-OBS-4.1 : SLO définis, jamais révisés ni reliés à une décision.
- Un 5 partiel : exercices de panne annuels et actions closes, mais télémétrie non pilotée en coût.
Fatigue d'alerte. Symptôme : les alertes sont ignorées ou mises en sourdine. Cause : alertes sur des causes, sans seuil actionnable. Remède : une alerte doit appeler une action humaine immédiate ; sinon, c'est un tableau de bord ou un rapport.
Succès technique, échec métier. Symptôme : le traitement est « vert », les chiffres sont périmés ou à moitié chargés. Cause : on supervise l'exécution, pas la donnée produite. Remède : contrôler fraîcheur, volumétrie et invariants (totaux croisés) après chaque chargement.
Alarmez sur l'absence d'un signal de réussite (dead man's switch) : c'est la seule façon de détecter qu'un planificateur lui-même est tombé.
Passer au niveau suivant#
Moyens possibles (facultatifs)
- 1 → 2 : vérifications d'état, alerte sur échec et sur absence d'exécution, astreinte nommée.
- 2 → 3 : journalisation structurée avec corrélation, métriques de service, analyses après incident.
- 3 → 4 : définir un SLO par service critique avec le métier, suivre le budget, supprimer toute alerte non actionnable.
- 4 → 5 : reprises idempotentes, exercices de panne, clôture systématique des actions.
Traitement de consolidation nocturne : niveau 1, on apprend à 9 h que les rapports sont vides. Niveau 3, une alerte à 6 h indique « chargement du lot SFA incomplet : 41 % des lignes attendues » grâce à un contrôle de volumétrie, avec identifiant de lot pour retrouver la cause en 10 minutes.
Un objectif de MTTR bas encourage à clore vite sans corriger la cause. Associez-le au taux de récurrence des incidents.
Voir aussi#
- Voisins : 06 Déploiement · 11 Performance · 09 Dette technique · 07 Sécurité.
- Autres matrices : BI — exploitation, supervision et capacité · Data — exploitation et support · Data — qualité des données.
- Pratique : CI/CD · métriques et reporting de projet · pièges et bonnes pratiques.
- Glossaire · Notation.
✻ Rédigé par Claude Sonnet 5.5
