

- Description
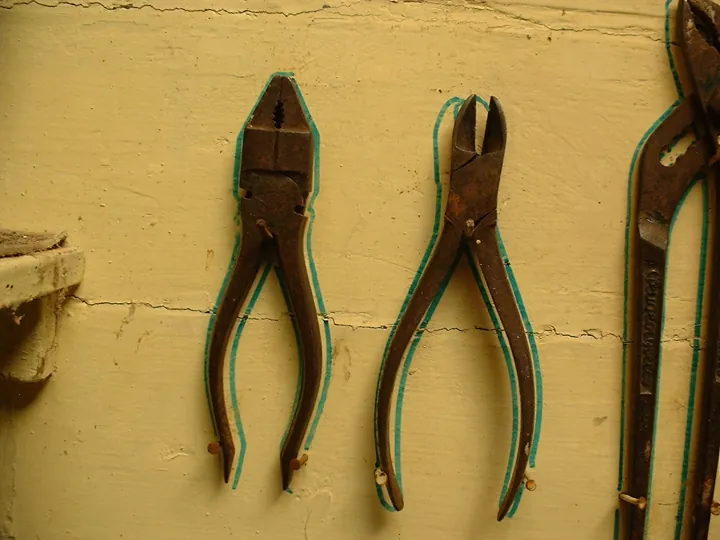
- Pinces accrochées à un mur d’atelier, chacune entourée du contour tracé de sa place.
- Source
- Syced · page d’origine
- Licence
- CC0 Domaine public
 Bonnes pratiques Power BI transverses
Les pratiques qui valent quelle que soit la source (Fabric / OneLake ou SQL Server managé) : modèle en étoile, nommage, DAX, Power Query, RLS, performance, thèmes, accessibilité…
En bref
- Les pratiques qui valent quelle que soit la source (Fabric / OneLake ou SQL Server managé) : modèle en étoile, nommage, DAX, Power Query, RLS, performance, thèmes, accessibilité, multilingue, versionnement, déploiement, gouvernance.
- Vous saurez construire un modèle sémantique lisible, rapide, sécurisé et versionné, et le faire vivre sans casser les rapports qui le consomment (règle du
lineageTag). - Vous disposerez d'un catalogue de plus de quarante pièges classiques avec symptôme, cause et remède.
- Interprétation du dossier : « OneLake + applications mobiles SaaS » et « SQL Server managé en SaaS » sont définis dans le README du dossier ; ce fichier ne dépend d'aucun des deux.
Sur cette page
- 1. Principes directeurs
- 2. Modèle en étoile
- 3. Nommage et conventions
- 4. DAX
- 5. Power Query et couche d'accès aux données
- 6. Sécurité de niveau ligne (RLS) et autres protections
- 7. Performance
- 8. Thèmes, visuels et accessibilité
- 9. Multilingue et traductions TMDL
- 10. PBIP, TMDL et Git
- 11. Deployment pipelines et environnements
- 12. Endorsement, catalogue et gouvernance
- 13. Mesures et lineageTag
- 14. Tests et recette des chiffres
- 15. Documentation
- 16. Pièges classiques
- 17. Contribution de l'IA
- 18. Voir aussi
Niveau : 🟢→🔴
1. Principes directeurs#
🟢 Novice — Cinq idées à retenir#
- Un rapport n'est que la vitrine d'un modèle. La qualité se joue dans le modèle sémantique (tables, relations, mesures) bien plus que dans la page.
- Mettre la complexité à la source. Ce qui peut être calculé en amont (SQL, lakehouse) doit l'être : un calcul fait une fois en amont vaut mieux que mille fois à la requête. À l'inverse, un calcul qui dépend du contexte de filtre appartient au DAX.
- Un nombre = une définition = une mesure. Un KPI qui existe en trois versions dans trois rapports est une dette de confiance.
- Tout doit être reconstructible depuis des fichiers versionnés. Si le modèle n'existe que dans un
.pbixsur un poste, il n'existe pas. - Mesurer avant d'optimiser, tester avant de livrer.
🟡 Pratique — Où se place chaque décision#
| Question | Couche recommandée | Pourquoi |
|---|---|---|
| Nettoyage, typage, clés de substitution | Source (SQL / lakehouse) | Une fois, testable, réutilisable par d'autres consommateurs |
| Jointures lourdes, agrégations fixes | Source ou vue/table matérialisée | Le moteur de stockage les fait mieux que Power Query |
| Renommage de colonnes pour l'utilisateur | Source ou modèle (traductions) — jamais en alias qui masque le nom du datamart | Garder la traçabilité colonne ↔ source |
| Mesures dépendant du contexte | DAX dans le modèle | Seul le moteur de formule connaît le filtre courant |
| Sécurité de ligne | Modèle (RLS) et source si accès direct | Défense en profondeur |
| Mise en forme | Thème JSON + modèle de page | Cohérence et changement en un point |
Écrivez une charte de modèle d'une page : nommage, conventions de date, devise, fuseau horaire, règle d'arrondi, définition des 10 KPI majeurs. Elle sert de contrat entre développeurs, et de support de relecture en revue de modèle (voir 11 — checklist).
2. Modèle en étoile#
🟢 Novice — Le principe#
Un schéma en étoile (Kimball, The Data Warehouse Toolkit) sépare des tables de faits (événements mesurables : visites, commandes, relevés) et des tables de dimensions (descriptions : client, produit, date, utilisateur). Les dimensions filtrent les faits, jamais l'inverse, au moins dans le sens principal : la relation est un-à-plusieurs, côté « un » = dimension, avec filtrage de la dimension vers le fait.
            DIM_Date
               │
 DIM_Client ── FACT_Visite ── DIM_Produit
               │
          DIM_Utilisateur
Pourquoi : le moteur colonne de Power BI (VertiPaq) compresse très bien les colonnes à faible cardinalité et répond vite à des filtres propagés de petites tables vers de grandes ; un modèle « plat » ou en flocon profond coûte en mémoire, en lisibilité et en risques d'ambiguïté.
🟡 Pratique — Règles concrètes#
| Règle | Détail |
|---|---|
| Une table de dates dédiée | Marquée comme table de dates, continue (aucun trou), sur l'horizon utile ; plusieurs rôles (date de visite, date de commande) par relations inactives + USERELATIONSHIP, ou par tables de dates distinctes quand le rôle est structurant |
| Clés de substitution entières | Plus compactes et stables que des clés texte composites ; pas de clé composite côté relation (Power BI ne les gère pas) |
| Granularité explicite | Chaque table de faits déclare sa grain : « une ligne = une visite par client par jour » |
| Colonnes de faits numériques masquées | On expose des mesures, pas des colonnes à sommer à la main |
| Relations plusieurs-à-plusieurs | À éviter ; préférer une table de pont et un filtrage contrôlé |
| Filtrage bidirectionnel | Exception justifiée et documentée, jamais par défaut |
| Colonnes inutiles | Supprimées du modèle : toute colonne non utilisée coûte en mémoire et en confusion |
| Dimensions « dégénérées » | Un numéro de document peut rester dans le fait s'il n'a pas d'attributs |
Rétro-filtrage des faits vers les dimensions. Symptôme : une mesure qui compte des clients donne des valeurs différentes selon l'utilisateur (rôle de sécurité) ou selon la sélection d'un autre visuel. Cause : une relation bidirectionnelle (ou un filtre de sécurité croisé) laisse les filtres d'une table de faits restreindre une dimension. Remède : relations en sens unique, mesures de comptage sur la dimension avec ALL/REMOVEFILTERS explicites quand le comptage ne doit pas dépendre de la sécurité, et tests de la mesure sous chaque rôle.
🔴 Expert — Cas limites et variantes#
- Dimensions à évolution lente (SCD). Type 2 : une ligne par version de l'attribut, avec bornes de validité. Dans Power BI, joindre le fait sur la clé de substitution de la version valide au moment de l'événement, pas sur la clé naturelle. Documenter si le rapport montre « l'attribut au moment de l'événement » ou « l'attribut actuel ».
- Rôles multiples d'une dimension (ex. employé créateur, employé vendeur) : plusieurs relations vers la même dimension (une active) ou plusieurs copies de la dimension ; choisir selon le besoin de filtrer simultanément.
- Tables de faits de grains différents (prévision à la semaine, réel au jour) : dimensions conformes partagées et mesures qui gèrent explicitement le grain (agrégation à la semaine).
- Semi-additivité (stocks, effectifs) : mesure dédiée (
LASTNONBLANK, instantané à la dernière date) ; ne jamais exposer la colonne brute à sommer. - Calculation groups pour les variantes de temps (cumul annuel, N-1, variation) : réduisent les dizaines de mesures dérivées, au prix d'un outillage (Tabular Editor, TMDL ou l'éditeur de groupes de calcul de Desktop) et d'une lisibilité à soigner.
- Agrégations (tables d'agrégats en Import devant une table DirectQuery) : gagnent un ordre de grandeur sur les grandes tables, à condition de tester que les requêtes « tombent » bien sur l'agrégat.
Fil rouge : un modèle SFA avec FACT_Visite (grain : une visite), FACT_Commande (grain : une ligne de commande), dimensions conformes DIM_Client, DIM_Produit, DIM_Utilisateur, DIM_Date. La mesure « Taux de couverture » compte les clients visités sur les clients du portefeuille : le dénominateur doit ignorer les filtres issus des faits (REMOVEFILTERS sur les colonnes concernées) sous peine de varier avec le rôle de sécurité.
3. Nommage et conventions#
🟢 Novice — Pourquoi nommer avec soin#
Le nom est la première documentation. Un utilisateur self-service choisit une mesure par son nom ; un développeur retrouve le code par son nom. Les noms de colonne qui viennent d'une source doivent rester identiques à ceux de la source : renommer côté Power Query casse la traçabilité et complique l'actualisation du schéma. Les libellés destinés à l'utilisateur passent par les traductions (§ 9), pas par des alias.
🟡 Pratique — Convention proposée#
| Objet | Convention | Exemple |
|---|---|---|
| Tables de dimensions | DIM_<Nom> (ou nom métier au singulier selon charte) |
DIM_Client |
| Tables de faits | FACT_<Nom> |
FACT_Visite |
| Tables de référence/valeurs | LUP_<Nom> |
LUP_StatutVisite |
| Tables de paramètres | PRM_<Nom> (mesure ou valeur) |
PRM_Devise |
| Table des mesures | _Mesures (ou plusieurs dossiers d'affichage) |
_Mesures |
| Mesures | Libellé métier lisible, avec unité si ambiguë | Chiffre d'affaires, Taux de couverture % |
| Mesures techniques | Préfixe _ et masquées |
_Nb lignes |
| Colonnes | Inchangées par rapport à la source | CLI_COD |
| Dossiers d'affichage | Regroupent par thème | Ventes\Chiffre d'affaires |
| Pages | Préfixe numérique stable | 01 Synthèse |
| Fichiers | AAAA-MM-JJ seulement pour des livrables figés, sinon version dans l'outil de GDS |
Rapport Standard.pbip |
Règles de forme : une casse cohérente, pas d'abréviation interne obscure, pas de caractères qui compliquent le DAX ou le TMDL (apostrophes en nom de table, par exemple), un suffixe d'unité quand deux mesures ne diffèrent que par l'unité (%, k€), et des déclinaisons nommées de façon systématique (base, variante, période).
Définissez une nomenclature des déclinaisons de mesure (par exemple : mesure de base, + filtre de population, + période fixe, + pourcentage) et appliquez-la par script. Une mesure déclinée à la main sera tôt ou tard incohérente avec ses sœurs.
Symptôme : un rapport utilisateur affiche « Colonne introuvable » après un renommage « pour faire plus joli ». Cause : le renommage dans le modèle a modifié la référence que le rapport utilisait (selon le format de rapport, les références sont textuelles). Remède : renommer en source avec un plan de migration, ou laisser le nom technique et traduire le libellé.
4. DAX#
🟢 Novice — Les trois notions#
- Contexte de ligne : « la ligne en cours » (colonne calculée, itérateur).
- Contexte de filtre : l'ensemble des filtres actifs (segments, lignes/colonnes du visuel, relations, RLS).
- Transition de contexte :
CALCULATEtransforme un contexte de ligne en contexte de filtre.
Chiffre d'affaires = SUM ( FACT_Commande[Montant] )

Chiffre d'affaires N-1 =
CALCULATE ( [Chiffre d'affaires], SAMEPERIODLASTYEAR ( DIM_Date[Date] ) )
Préférer une mesure à une colonne calculée dès que la valeur dépend du filtre ; une colonne calculée est stockée (mémoire) et recalculée à l'actualisation.
🟡 Pratique — Écrire un DAX durable#
- Variables (
VAR/RETURN) : lisibilité, évaluation unique, débogage plus simple. - Division sûre :
DIVIDE ( num, den )plutôt que/pour gérer le dénominateur nul. - Pas de
IFERRORsystématique : il masque des erreurs de modèle ; traiter la cause. - Filtres sur colonnes, pas sur tables :
CALCULATE ( [M], DIM_Client[Pays] = "FR" )— un filtre de table entière (FILTER ( ALL ( Table ), ... )) est lent et sur-contraint. - Mesures de base réutilisées : chaque KPI dérivé s'appuie sur une mesure de base unique, pas sur une copie de la formule.
- Itérateurs avec parcimonie :
SUMXsur une grande table coûte ; si l'expression n'est pas dépendante de la ligne, utiliserSUM. - Intelligence temporelle avec la table de dates marquée ; éviter les calculs temporels sur des colonnes de date du fait.
- Mesures « % » : séparer numérateur, dénominateur, ratio pour tester chaque terme.
- Formatage : une mise en forme normalisée (DAX Formatter ou outil équivalent) rend les revues lisibles.
Taux de couverture % =
VAR _Visites   = CALCULATE ( DISTINCTCOUNT ( FACT_Visite[ID_Client] ) )
VAR _Portefeuille =
    CALCULATE (
        DISTINCTCOUNT ( DIM_Client[ID_Client] ),
        REMOVEFILTERS ( FACT_Visite )
    )
RETURN
    DIVIDE ( _Visites, _Portefeuille )
Un « nombre de clients » défini en comptant DIM_Client vaut 12 000 pour un administrateur, mais 800 pour un représentant sous RLS : c'est normal et correct ; en revanche, un ratio dont le dénominateur varie avec le rôle sans que le métier l'ait voulu est un défaut de définition. Écrire la définition métier avant la formule.
🔴 Expert — Moteur, plans et mesures coûteuses#
- Deux moteurs : le moteur de formule (évalue le DAX, mono-thread) et le moteur de stockage (VertiPaq : requêtes xmSQL, multi-thread). Une mesure lente est presque toujours une mesure qui sollicite beaucoup le moteur de formule (itérateurs imbriqués, matérialisations volumineuses) ou qui provoque de nombreux callbacks.
- Outils d'analyse : Performance Analyzer (dans Desktop) pour repérer le visuel coupable, DAX Studio (requêtes, plans, Server Timings) pour comprendre, Tabular Editor pour les scripts et règles de bonnes pratiques (Best Practice Analyzer), et la vue DAX query de Desktop.
- Cardinalité : une colonne texte à forte cardinalité (identifiants, horodatages à la seconde) pèse lourd ; scinder date et heure, tronquer, ou ne pas importer.
- Colonnes calculées en cascade : éviter ; préférer calcul en amont.
- Relations inactives et
USERELATIONSHIP: à tester sous RLS (le comportement de sécurité et les relations inactives demande une vérification explicite). - Mesures à évaluation par lot : la fonction
SUMMARIZECOLUMNSest généralement plus efficace que des combinaisons deADDCOLUMNS/SUMMARIZEpour les tables de requête ; réfléchir au grain de sortie. - Valeurs vides : une mesure qui retourne
0au lieu deBLANK()force l'affichage de toutes les combinaisons (lignes vides) et dégrade les performances ; retournerBLANK()quand « pas de donnée » est sémantiquement vrai.
Avant d'optimiser une mesure, isolez-la : exécutez la requête du visuel dans DAX Studio avec cache vidé, notez durée totale / part moteur de formule / part moteur de stockage / nombre de requêtes de stockage. Après modification, comparez les mêmes quatre chiffres. Sans ces valeurs, « c'est plus rapide » est une impression.
5. Power Query et couche d'accès aux données#
🟢 Novice — À quoi sert Power Query (et à quoi il ne sert pas)#
Power Query (langage M) charge et prépare les données : connexion, typage, filtres de lignes, fusion. Il n'est pas un moteur de transformation industriel : il convient à du nettoyage léger, pas à des jointures de centaines de millions de lignes.
🟡 Pratique — Règles#
| Règle | Détail |
|---|---|
| Query folding | Préserver la délégation des étapes à la source (le moteur SQL fait le travail). Vérifier « Afficher la requête native » ; une étape non repliable casse le repli pour les suivantes. |
| Interroger des vues ou tables de la couche d'exposition, pas des tables techniques | La source garde la liberté de changer l'implémentation sans casser les modèles. |
| Paramètres | Serveur, base, environnement, plage de dates : en paramètres pour changer d'environnement sans modifier les requêtes. |
| Une requête de chargement par table | Pas de requêtes enchaînées inutiles ; désactiver le chargement des requêtes intermédiaires. |
| Types explicites | Définir les types en dernière étape, avec des types fiables ; attention aux conversions locales (virgule/point décimaux, formats de date) : fixer la culture. |
| Actualisation incrémentale | Partitions par date de modification fiable (RangeStart/RangeEnd), filtre repliable ; tester le repli. |
| Pas de secrets en clair | Identifiants dans la passerelle/source de données, jamais dans le M. |
| Colonnes inutiles | Retirées le plus tôt possible. |
let
    Source = Sql.Database(Serveur, Base),
    Faits = Source{[Schema = "dbo", Item = "FACT_Visite"]}[Data],
    Filtrage = Table.SelectRows(
        Faits,
        each [DateModification] >= RangeStart and [DateModification] < RangeEnd
    )
in
    Filtrage
🔴 Expert — Fabric et SaaS#
- Avec Direct Lake, Power Query disparaît de la lecture des données du modèle : la préparation vit dans le lakehouse/warehouse (notebooks, pipelines, dataflows Gen2). Les règles de nommage et de typage se déplacent en amont ; garder leur discipline. Voir 02 — architecture OneLake.
- Les dataflows Gen2 servent à des préparations répétables par des profils moins techniques, mais consomment de la capacité : mesurer.
- Les sources SaaS exposent des API à quotas : isoler l'extraction dans un composant dédié (pipeline, fonction) avec reprise, pas dans une requête Power Query interactive. Voir 03 — difficultés et pièges (OneLake).
- Côté SQL managé : exposer des vues de reporting versionnées et testées ; voir 06 — architecture SQL Server.
Symptôme : l'actualisation devient trois fois plus lente après l'ajout d'une colonne calculée. Cause : l'étape casse le repli, toute la table est rapatriée puis traitée localement. Remède : faire la transformation dans la source (vue) ou réordonner les étapes pour que les repliables précèdent.
6. Sécurité de niveau ligne (RLS) et autres protections#
🟢 Novice — Le principe#
La RLS limite les lignes visibles par utilisateur ou groupe. Définie dans le modèle sémantique, avec des rôles dont les expressions filtrent des tables (généralement des dimensions) ; les filtres se propagent aux faits par les relations.
🟡 Pratique — RLS statique et dynamique#
- Statique : un rôle par périmètre (
[Pays] = "FR"). Simple, mais prolifère. - Dynamique : table de correspondance
utilisateur → périmètreet filtre surUSERPRINCIPALNAME().
-- Rôle « Représentant » sur DIM_Utilisateur
[Email] = USERPRINCIPALNAME ()
| Bonne pratique | Pourquoi |
|---|---|
| Filtrer les dimensions, laisser les relations propager | Moins de règles, plus de lisibilité |
| Table de sécurité dans le modèle ou dans la source, maintenue hors Desktop | Les droits changent plus vite que les rapports |
| Hiérarchies d'utilisateurs aplaties (manager → subordonnés) calculées en amont | Éviter les PATH coûteux à chaque requête |
| Tester en « Afficher en tant que » avec chaque rôle et un utilisateur multi-rôles | Les rôles s'additionnent (union) pour un même utilisateur |
| Un rôle sans expression de filtre n'est pas « tout interdit » | Il donne accès à toutes les lignes ; un lecteur sans rôle assigné ne voit en principe aucune donnée : vérifier le comportement |
| Documenter la matrice rôle × table × expression | Audit et relecture |
🔴 Expert — Limites et interactions#
- OLS (sécurité de niveau objet) masque colonnes ou tables ; à combiner avec la RLS, avec les limites de compatibilité des outils clients.
- Propriétaires de l'espace de travail et rôles Contributeur/Membre/Administrateur contournent la RLS : ne donnez pas ces rôles aux consommateurs.
- Direct Lake / SQL endpoint / DirectQuery : la sécurité doit être pensée aux deux niveaux (modèle et source) ; le comportement dépend de l'identité utilisée (SSO ou compte fixe) et des états de fonctionnalité de la plateforme (à vérifier, état 2026-10).
- Intégration (rapports intégrés dans une application) : l'identité effective et les rôles se passent dans le jeton d'intégration ; une erreur ici est une fuite de données.
- Performance : une expression RLS qui référence des tables volumineuses ou utilise des fonctions coûteuses se paie à chaque requête de chaque utilisateur.
- Cache : les caches de visuels et de requêtes sont partitionnés par identité de sécurité ; beaucoup de rôles distincts réduisent le taux de succès du cache.
- Données sensibles : étiquettes de sensibilité, restrictions d'export, pas de données personnelles inutiles dans le modèle (minimisation RGPD).
Symptôme : un utilisateur voit tout dans l'espace de travail de test, rien en production. Cause : il est membre de l'espace de test (donc hors RLS), simple lecteur en production. Remède : tester la RLS avec un compte de test lecteur réel, pas avec son compte d'administrateur.
7. Performance#
🟢 Novice — Les quatre leviers#
- Moins de données : colonnes et lignes strictement nécessaires.
- Meilleur modèle : étoile, relations simples, types adaptés.
- Mesures efficaces (§ 4).
- Moins de visuels par page : chaque visuel déclenche au moins une requête.
🟡 Pratique — Méthode#
| Étape | Outil | Question |
|---|---|---|
| Mesurer la page | Performance Analyzer | Quel visuel prend du temps ? Requête DAX, affichage ou « autre » ? |
| Isoler la requête | DAX Studio (Server Timings) | Moteur de formule ou de stockage ? Combien de requêtes de stockage ? |
| Analyser le modèle | VertiPaq Analyzer / métriques de modèle | Quelles colonnes pèsent ? Quelle cardinalité ? |
| Vérifier la source | Plans de requête, Query Store, statistiques | (DirectQuery) la requête native est-elle bien indexée ? |
| Confirmer en usage réel | Journaux d'utilisation, application de métriques | Les gains se voient-ils en production ? |
Bonnes pratiques de page : peu de visuels (une dizaine) ; segments en liste déroulante plutôt qu'en longue liste ; filtres de page appliqués plutôt que mesures exclues ; info-bulles de page conçues pour être légères ; boutons de signet plutôt que dix pages quasi identiques ; éviter les visuels qui demandent des tables de plusieurs milliers de lignes.
Sur un modèle Import de 4 Go, la colonne HeureEvenement (horodatage à la seconde, forte cardinalité) pesait 600 Mo. Scindée en Date (clé vers DIM_Date) et Heure (arrondie à la minute, 1 440 valeurs), le modèle est passé à ~3,2 Go et les temps de chargement ont baissé d'environ un cinquième (chiffres illustratifs).
🔴 Expert — Selon le mode de stockage#
| Mode | Leviers spécifiques |
|---|---|
| Import | Actualisation incrémentale, partitionnement, colonnes de moindre cardinalité, agrégations, grand format de modèle si nécessaire |
| DirectQuery | Index columnstore, statistiques à jour, vues optimisées, agrégations Import, limite du nombre de requêtes parallèles, réduction du nombre de visuels, éviter les mesures qui génèrent des sous-requêtes imbriquées |
| Composite | Modèles à plusieurs îlots : mode double pour les dimensions, attention aux « relations limitées » (faiblement typées) |
| Direct Lake | Compactage des fichiers Delta, V-Order, éviter le repli DirectQuery (surveiller le mode effectivement utilisé), taille de rowgroup cohérente, pas de colonnes calculées complexes dans le modèle |
Surveiller capacité (lissage, rejet) et concurrence : une page lente à 17 h est souvent une page normale dans une capacité saturée par des chargements concurrents. Voir 09 — comparatif pour les arbitrages de plateforme.
8. Thèmes, visuels et accessibilité#
🟢 Novice — Le thème comme contrat visuel#
Un thème JSON fixe palette, typographie, styles de visuels. Il garantit la cohérence et permet de changer l'identité en un fichier. Un thème minimal :
{
  "name": "Thème Académie",
  "dataColors": ["#1F4E79", "#2E86AB", "#F18F01", "#C73E1D", "#6B8E23", "#7D5BA6"],
  "background": "#FFFFFF",
  "foreground": "#1B1B1B",
  "tableAccent": "#1F4E79",
  "textClasses": {
    "title":  { "fontFace": "Segoe UI Semibold", "fontSize": 14 },
    "label":  { "fontFace": "Segoe UI", "fontSize": 10 }
  }
}
🟡 Pratique — Accessibilité#
| Exigence | Mise en œuvre |
|---|---|
| Contraste | Rapport de contraste texte/fond d'au moins 4,5:1 pour le texte courant (repère WCAG 2.x) ; vérifier avec un outil |
| Pas d'information par la seule couleur | Ajouter forme, motif, étiquette ou valeur |
| Texte alternatif | Renseigné sur tous les visuels porteurs d'information ; visuels décoratifs marqués comme tels |
| Ordre de tabulation | Défini logiquement (titre, filtres, visuels principaux) |
| Titres de visuels | Explicites, en langage métier |
| Taille de police | Lisible, minimum d'environ 10 à 12 pt pour les étiquettes |
| Navigation clavier | Testée sans souris |
| Lecteur d'écran | Tester au moins un parcours complet |
| Palette adaptée au daltonisme | Palettes validées ; éviter rouge/vert comme seul codage |
| Mobile | Mise en page téléphone dédiée pour les rapports consommés sur le terrain |
Sur le mobile (application Power BI), concevoir une disposition verticale dédiée, des cartes KPI, peu de filtres et des cibles tactiles suffisantes ; tester hors ligne si le cas d'usage le requiert (les capacités hors ligne sont limitées, à vérifier).
🔴 Expert — Gabarits et gouvernance du visuel#
- Modèle de rapport (
.pbit) ou rapport de base partagé : en-tête, pied, navigation, thème, pages d'aide. - Visuels personnalisés : n'utiliser que des visuels certifiés ou audités ; un visuel tiers est du code exécuté dans le rapport.
- Cohérence entre rapports : bibliothèque de composants (cartes KPI, tables) documentée.
- Lisibilité : une page = une question ; titres qui énoncent la conclusion (« les ventes baissent dans le Sud ») plutôt que l'objet (« Ventes par région »).
- Surcharge cognitive : limiter le nombre de couleurs, aligner, supprimer le bruit (grilles superflues, ombres).
Symptôme : un rapport « magnifique » n'est pas utilisé. Cause : conçu pour impressionner, pas pour répondre aux 3 questions de l'utilisateur terrain. Remède : partir des décisions (« que doit faire le commercial après avoir regardé ? »), valider avec un utilisateur réel sur un prototype papier ou page unique.
9. Multilingue et traductions TMDL#
🟢 Novice — Deux sujets distincts#
- Traduire les métadonnées du modèle (noms de tables, colonnes, mesures, dossiers d'affichage, descriptions) : le visiteur voit « Chiffre d'affaires » ou « Revenue » selon la langue de son client.
- Traduire le contenu (valeurs des dimensions, libellés de données) : cela se joue dans les données (colonnes par langue, table de libellés).
- Les textes du rapport (titres, zones de texte, info-bulles) ne suivent pas toujours la traduction du modèle : les prévoir à part (mesures de titre dynamiques, par exemple).
🟡 Pratique — Traductions dans le modèle (cultures)#
Le modèle sémantique accepte des cultures (langues) avec, pour chaque objet, un translatedCaption, translatedDescription, translatedDisplayFolder. En TMDL, elles se déclarent dans le dossier cultures/ du modèle (un fichier par culture), avec des blocs linguisticMetadata à part.
Modèle.SemanticModel/
  definition/
    model.tmdl
    tables/
    cultures/
      fr-FR.tmdl
      en-US.tmdl
      de-DE.tmdl
Extrait indicatif d'un fichier de culture (la syntaxe exacte est à valider sur votre version de l'outil ; état 2026-10, à vérifier) :
cultureInfo fr-FR

  translations
    model Model
      table 'FACT_Visite'
        caption: Visites
        measure 'Nb visites'
          caption: Nombre de visites
          description: Nombre de visites réalisées sur la période
          displayFolder: Activité
Bonnes pratiques :
| Règle | Pourquoi |
|---|---|
| Source de vérité des libellés unique (table de traductions en base, ou fichier) et génération des cultures par script | Traductions cohérentes, reproductibles, relues par un humain |
| Chaque objet exposé a une traduction pour chaque langue supportée | Un libellé manquant s'affiche dans la langue d'origine : incohérence visible |
| Langue source = langue d'écriture du modèle | Les colonnes gardent leur nom technique ; la traduction fait le libellé |
| Les dossiers d'affichage sont traduits aussi | Sinon le volet Champs mélange les langues |
| Contrôle automatisé de complétude (objets sans traduction) | À mettre en CI |
| Revue par un locuteur natif métier | La traduction automatique d'un terme métier est souvent fausse |
| Fixer formats (date, nombre, devise) par culture | Les utilisateurs lisent des formats locaux |
🔴 Expert — Pièges du multilingue#
- Traductions et références du rapport : les rapports référencent les objets par leur nom source ; la traduction ne change pas la référence, d'où l'importance de ne jamais renommer à la place de traduire.
- Mesures de titre dynamiques :
SELECTEDVALUE ( LUP_Libelle[Texte] )filtré par langue, ouUSERCULTURE()dans la mesure (selon les contextes, vérifier le comportement dans le service). - Tri : les colonnes traduites doivent avoir un tri par colonne cohérent (clé numérique), sinon l'ordre change selon la langue.
- Langue du client : le service sélectionne la culture selon les paramètres du navigateur ou de l'application mobile ; prévoir une langue par défaut.
- Contenu à plusieurs langues : privilégier un modèle « libellé par langue » (table de libellés avec
LANG_COD) à des colonnesLibelle_FR,Libelle_ENqui multiplient les colonnes. - Suppression/ajout d'une langue : procédure documentée ; une nouvelle langue = une nouvelle culture + scripts + recette.
Traitez la traduction comme un pipeline de données : libellés en base → script de génération → fichiers cultures/*.tmdl → validation syntaxique → revue de complétude → publication. Un pipeline reproductible évite les dérives entre langues, et vos équipes ne retraduisent plus à la main à chaque version. Voir la matrice Accessibilité et multilingue.
10. PBIP, TMDL et Git#
🟢 Novice — Pourquoi sortir du .pbix#
Un .pbix est un fichier binaire : on ne peut ni le comparer, ni le fusionner, ni le relire en revue. Le projet Power BI (.pbip) découpe un rapport en fichiers texte : un dossier *.SemanticModel (modèle, en TMDL) et un dossier *.Report (définition du rapport). On peut alors utiliser un gestionnaire de versions, comparer, faire des revues.
MonRapport.pbip
MonRapport.SemanticModel/
  definition.pbism
  definition/
    model.tmdl
    relationships.tmdl
    tables/*.tmdl
    cultures/*.tmdl
MonRapport.Report/
  definition.pbir
  definition/        (format PBIR : un fichier par page/visuel)
🟡 Pratique — Règles de versionnement#
| Règle | Détail |
|---|---|
| Versionner les sources, pas les caches | Exclure .pbi/cache.abf et .pbi/localSettings.json (.gitignore et .tfignore) |
| Encodage | Les fichiers TMDL/PBIR sont produits par Desktop en UTF-8 sans BOM : ne pas les convertir ni ajouter de BOM, Desktop les réécrit à chaque enregistrement |
| Fins de ligne | Laisser celles de l'outil ; ne pas « normaliser » sans test (voir GDS et données SQL/BI) |
| Commits atomiques | Un changement de modèle (mesure, relation) par commit, message qui dit pourquoi |
| Branches | Une branche par évolution, revue avant fusion ; voir stratégies de branches |
| Fusion | Les .tmdl fusionnent bien (une mesure = un bloc) ; les diagramLayout.json produisent des conflits sans valeur : accepter l'une ou l'autre version |
| Un seul éditeur à la fois sur un même modèle | Si possible : Desktop réécrit des fichiers entiers |
| Validation syntaxique avant d'ouvrir | Script de contrôle TMDL en CI/pré-commit : une erreur de syntaxe empêche l'ouverture du projet |
| Rapport et modèle séparables | Un rapport lié à un modèle publié (modèle partagé) plutôt qu'un rapport « tout-en-un », pour réutiliser et gouverner |
Outils : Power BI Desktop (mode développeur), Tabular Editor, éditeur de texte avec extension TMDL, Fabric Git integration (synchronisation d'un espace de travail avec Git ; limites et prises en charge de fournisseur à vérifier, état 2026-10 — Azure DevOps cloud est le cas de référence ; pour un TFS/Azure DevOps Server sur site, prévoir un chemin de publication par pipeline). Pour TFVC, voir TFVC en profondeur : l'absence d'intégration native impose un processus manuel/scripté de dépôt et de déploiement.
Symptôme : deux développeurs modifient le même modèle ; la fusion produit un projet qui ne s'ouvre plus. Cause : conflit sur des propriétés structurelles (deux colonnes isKey sur une table, relations dupliquées, lineageTag en double). Remède : contrôles automatisés (une seule clé par table, identifiants uniques) avant fusion ; revue du diff TMDL.
🔴 Expert — Format de rapport et dérives#
- PBIR (rapport en fichiers JSON par page et par visuel) est le format cible du projet de rapport, plus adapté au diff que l'ancien format monolithique ; il devient le format par défaut de Desktop et du service (annonce Microsoft du 1er septembre 2026, déploiement de mi- à fin septembre 2026) ; l'ancien format reste pris en charge. Vérifier la documentation (état 2026-10).
- Références par alias dans les requêtes de visuels : un renommage de colonne laisse des références périmées ; scripter le renommage et valider par ouverture du rapport.
- Modifier à la main les fichiers de rapport est possible mais fragile ; préférer des scripts testés ou l'outil, et toujours rouvrir dans Desktop pour valider.
- Fichiers générés (mise en page du diagramme, états de l'éditeur) : exclure de la revue ou les ignorer.
- Livraison par kits : le modèle publié s'accompagne de scripts (SQL, PowerShell) ; versionner ensemble modèle, scripts de la source et documentation, avec une version commune ; voir CI/CD pour la data.
11. Deployment pipelines et environnements#
🟢 Novice — Dev, Test, Prod#
Trois espaces de travail (au moins) : Développement, Test/Recette, Production. On développe dans le premier, on valide dans le second, on publie dans le troisième. Les deployment pipelines de Fabric/Power BI automatisent la promotion d'un étage à l'autre, avec règles de déploiement (paramètres, sources de données) propres à chaque étape.
🟡 Pratique — Règles#
| Règle | Détail |
|---|---|
| Paramétrer sources et environnements | Serveur, base, URL : par règles de déploiement ou paramètres, jamais en dur |
| Données de test réalistes mais protégées | Pas de données personnelles réelles en développement ; jeux anonymisés/synthétiques |
| Comparer avant de promouvoir | La comparaison de pipeline montre les écarts ; relire |
| Promotion = même artefact | Ne jamais rebâtir pour la production |
| Droits | Les développeurs n'écrivent pas directement en production |
| Capacité | Une capacité de recette dimensionnée comme la production, sinon les tests de performance mentent |
| Retour arrière | Plan de repli : version précédente conservée, procédure testée |
| Automatisation | Appels d'API/PowerShell depuis le pipeline de livraison (Azure DevOps, GitHub Actions) pour la promotion et le rafraîchissement |
Alternative ou complément quand le déploiement natif ne suffit pas : publication du modèle par XMLA (outils en ligne de commande, scripts TMDL) depuis un pipeline CI/CD — fonctionnement et état d'accès XMLA en écriture à vérifier selon votre licence (état 2026-10).
🔴 Expert — Cycle de vie complet#
- Orchestration : base (scripts SQL) → modèle → rapports → rafraîchissement → tests → notification. L'ordre compte : publier un modèle qui référence une colonne pas encore déployée en base casse le chargement.
- Compatibilité ascendante : les rapports consommateurs dépendent du modèle ; un changement cassant (renommage, suppression de mesure) exige un préavis, une période de coexistence et la liste des consommateurs (lignage).
- Versions de modèle : numéro de version visible (mesure
Version du modèle, page « À propos »), cohérent avec le tag du dépôt. - Migration de schéma de données : scripts idempotents, rejouables, avec contrôle de pré-requis.
12. Endorsement, catalogue et gouvernance#
🟢 Novice — Rendre fiable ce qu'on partage#
- Promu : « je recommande ce contenu » (par le propriétaire).
- Certifié : validé par des personnes habilitées selon des critères de l'organisation.
- Le catalogue (catalogue OneLake, Purview) permet de trouver les contenus et leur lignage.
🟡 Pratique — Gouvernance utile, pas bureaucratique#
| Sujet | Recommandation |
|---|---|
| Rôles | Propriétaire de données, propriétaire de modèle, auteurs de rapports, consommateurs, administrateurs de capacité |
| Modèles partagés/certifiés | Un petit nombre de modèles certifiés pour le self-service, des rapports légers au-dessus |
| Critères de certification | Documentation, tests de chiffres réussis, sécurité testée, propriétaire identifié, SLA d'actualisation |
| Espaces de travail | Un propriétaire, un but, des conventions de nommage, une revue périodique des espaces orphelins |
| Étiquettes de sensibilité | Appliquées par défaut ; héritage vers exports |
| Paramètres du locataire | Export, partage externe, publication sur le web : décidés et documentés |
| Surveillance | Journaux d'activité, inventaire des contenus (API d'administration), usage réel |
| Cycle de vie | Archiver les rapports non utilisés (par ex. aucune consultation sur 6 mois) après préavis |
🔴 Expert — Self-service sans chaos#
- Distinguer zones : certifiée (contrôlée), équipe (semi-libre), personnelle (libre, non fiable). Chaque zone a ses règles, et l'utilisateur sait dans laquelle il se trouve.
- Modèles composites au-dessus d'un modèle certifié : permettent l'extension locale sans copie, mais exigent de comprendre les chaînes de dépendance et la sécurité (la RLS du modèle source s'applique).
- Mesure de la gouvernance : taux de rapports utilisant un modèle certifié, nombre de modèles dupliqués, âge moyen des rapports, % d'espaces avec propriétaire. Voir la matrice Gouvernance, catalogue et self-service.
- Capacité : étiquetage des charges par domaine pour la refacturation interne ; voir 12 — coût, licences et capacité.
13. Mesures et lineageTag#
🟢 Novice — Pourquoi c'est un sujet à part#
Chaque objet d'un modèle (table, colonne, mesure) porte un lineageTag : identifiant stable qui permet aux outils de reconnaître « le même objet » malgré un renommage ou un déplacement. Les rapports et certains artefacts dérivés (rapports liés, modèles composites, métriques) s'appuient sur cette identité.
🟡 Pratique — La règle absolue#
Une mesure se modifie en place ; elle ne se supprime pas pour être recréée. Supprimer puis recréer une mesure génère un nouveau lineageTag : les rapports clients liés à l'ancien identifiant perdent la référence, même si le nom est identique.
Conséquences opérationnelles :
- Utiliser les instructions de script qui remplacent (
createOrReplaceen TMDL) sur le même objet en conservant lelineageTagdans la définition, plutôt qu'un cycledeletepuiscreate. - Dans une revue de diff TMDL, surveiller toute ligne
lineageTagqui change ou toute mesure qui disparaît puis réapparaît : c'est un signal d'alerte. - Les générateurs de mesures (déclinaisons) doivent relire le
lineageTagexistant et le réécrire. - Les changements cassants (suppression, renommage) passent par un préavis et une période de coexistence (mesure ancienne conservée, marquée obsolète dans sa description).
- Garder une liste de mesures publiques (consommées hors du modèle) distincte des mesures internes.
measure 'Chiffre d''affaires' = SUM ( FACT_Commande[Montant] )
    formatString: #,0
    displayFolder: Ventes
    lineageTag: 3f8d2c1e-0b7a-4d59-9a62-5c1d7e4b9a10
🔴 Expert — Cas limites#
- Duplication d'un modèle (copie de projet) : les
lineageTagsont copiés ; deux modèles « frères » partagent des identités ; cela peut être voulu (fork) ou source de confusion dans le lignage — décider. - Fusion de branches : deux branches qui ajoutent la même mesure avec des
lineageTagdifférents créent un conflit logique, pas textuel : revue indispensable. - Outils de refactoring (renommage en masse) : vérifier qu'ils conservent les tags.
- Rapports clients : les rapports hors périmètre direct de l'équipe (livrés à des clients, adaptés localement) sont ceux qui cassent en silence : inventorier.
Symptôme : « après la mise à jour du modèle, les visuels de plusieurs rapports clients affichent une erreur sur la mesure X ». Cause : la mesure a été supprimée et recréée par un script de génération, nouvel identifiant. Remède : restaurer l'ancien lineageTag (le retrouver dans l'historique de la GDS), réécrire le script pour relire/écrire les tags, ajouter un contrôle de non-régression (aucun tag existant ne disparaît) en CI.
14. Tests et recette des chiffres#
🟢 Novice — Tester un rapport, c'est tester des nombres#
L'erreur la plus coûteuse en BI n'est pas un bug d'interface : c'est un chiffre faux que personne ne remet en cause. Il faut donc une recette métier sur des chiffres connus.
🟡 Pratique — Niveaux de test#
| Niveau | Quoi | Comment |
|---|---|---|
| Source | Volumétrie, doublons, clés orphelines, nulls interdits, plages de valeurs | Requêtes SQL de contrôle, tests de données (voir qualité des données) |
| Réconciliation | Total modèle = total source (par jour, par entité) | Requête DAX vs requête SQL, tolérance définie |
| Modèle | Mesures sur jeux connus | Tests de requêtes DAX avec résultat attendu figé |
| Sécurité | Chaque rôle voit ce qu'il doit voir, rien de plus | Matrice de tests par rôle |
| Performance | Temps de chargement des pages clés, charge concurrente | Scénarios chronométrés |
| Visuel | Rendu, libellés, traductions, accessibilité | Check-list de revue (voir 11 — checklist) |
| Non-régression | Jeu de KPI figé avant/après changement | Comparaison automatique |
| Recette métier | Un utilisateur clé valide ses chiffres de référence | PV signé, chiffres source cités |
// Test DAX (à exécuter dans DAX Studio ou la vue de requêtes) : écart entre deux définitions
EVALUATE
ROW (
    "Mesure", [Chiffre d'affaires],
    "Contrôle", CALCULATE ( SUMX ( FACT_Commande, FACT_Commande[Qte] * FACT_Commande[PrixUnitaire] ) ),
    "Ecart", [Chiffre d'affaires]
        - CALCULATE ( SUMX ( FACT_Commande, FACT_Commande[Qte] * FACT_Commande[PrixUnitaire] ) )
)
🔴 Expert — Automatiser#
- Jeu de référence figé : chiffres attendus sur une période close, stockés dans le dépôt ; toute modification de mesure rejoue le jeu.
- Exécution de requêtes DAX par ligne de commande ou API depuis le pipeline (point de terminaison de requêtes du modèle publié ; limites et droits à vérifier).
- Tests de données en continu après chaque chargement (seuils d'alerte : variation de volumétrie > x % d'un jour à l'autre).
- Données de test : jeux représentatifs, cas limites (valeurs nulles, caractères accentués, fuseaux, fin de mois, années bissextiles, clients sans visite).
- Tests de bascule de langue : afficher le rapport dans chaque langue.
- Tolérance : décider si l'écart admissible est absolu, relatif, ou nul (comptages exacts, montants à l'arrondi près).
Un jeu de 25 KPI figés sur le mois clos précédent ; chaque évolution du modèle déclenche leur recalcul et la comparaison. Un écart de 0,01 % sur « marge » révèle un changement d'arrondi dans une vue : sans test, il aurait été découvert par un client trois mois plus tard.
15. Documentation#
🟡 Pratique — Ce qui doit être écrit#
| Document | Contenu | Où |
|---|---|---|
| Dictionnaire de mesures | Nom, définition métier, formule, unité, propriétaire, date de dernière révision | Dans le modèle (descriptions) et exporté |
| Dictionnaire de colonnes | Origine (table/colonne source), règle de transformation, qualité | Propriétés étendues de la source, descriptions du modèle |
| Schéma du modèle | Diagramme en étoile et grains | Dépôt, régénéré |
| Matrice de sécurité | Rôles, expressions, tests | Dépôt |
| Guide d'exploitation | Chaîne d'actualisation, reprises, contacts, SLA | Wiki d'équipe |
| Notes de version | Changements visibles, cassants, à tester | Journal de modifications versionné |
| Page « À propos » du rapport | Version, date des données, définitions, contact | Dans le rapport |
Placez la documentation au plus près de l'objet : description de mesure dans le modèle, propriété étendue sur la colonne en base, README dans chaque dossier du dépôt. La documentation séparée du code vieillit plus vite que le code.
Générez automatiquement le dictionnaire à partir du modèle (TMDL ou API) à chaque version ; ajoutez au contrôle de revue « toute mesure sans description est refusée ». Voir métadonnées, lignage et documentation.
16. Pièges classiques#
Catalogue transversal : symptôme → cause → remède.
16.1 Modèle#
| # | Symptôme | Cause | Remède |
|---|---|---|---|
| 1 | Totaux faux, doublons | Relation plusieurs-à-plusieurs ou clé non unique côté « un » | Dédoublonner la dimension, pont explicite |
| 2 | Valeurs qui changent selon le rôle RLS | Filtrage bidirectionnel / rétro-filtre | Sens unique, REMOVEFILTERS sur le dénominateur |
| 3 | Dates manquantes dans les graphiques | Table de dates non continue ou non marquée | Table de dates complète, marquée |
| 4 | Intelligence temporelle muette | Utilisation d'une colonne de date du fait | Utiliser DIM_Date[Date] |
| 5 | Modèle énorme | Colonnes inutiles, horodatages, texte long | Supprimer, scinder, réduire la cardinalité |
| 6 | Ambiguïté de chemins | Plusieurs relations actives entre mêmes tables | Une seule active, les autres inactives |
| 7 | Clé « composite » impossible | Power BI n'a pas de relation multi-colonnes | Clé de substitution unique |
| 8 | Deux colonnes marquées « clé » sur une table | Fusion ou édition manuelle | Une seule isKey par table, contrôle automatisé |
| 9 | Lignes « (Vide) » dans les dimensions | Clés orphelines dans les faits | Ligne « Inconnu » dans la dimension, contrôle d'intégrité |
| 10 | Mesure qui affiche tout le temps 0 | 0 au lieu de BLANK() ou types incompatibles |
Retourner BLANK(), vérifier les types |
16.2 DAX#
| # | Symptôme | Cause | Remède |
|---|---|---|---|
| 11 | Mesure lente | Itérateur sur grande table, filtre de table entière | Filtres sur colonnes, SUM quand possible |
| 12 | Résultat différent dans un tableau et dans une carte | Contexte de filtre différent | Tester avec et sans filtres, documenter |
| 13 | Division par zéro | / sans garde |
DIVIDE |
| 14 | IFERROR partout |
Erreurs masquées | Traiter la cause |
| 15 | Mesures copiées-collées | Formule dupliquée | Mesure de base partagée |
| 16 | Total ≠ somme des lignes | Non-additivité d'une mesure | Définir le total explicitement (HASONEVALUE, ISINSCOPE) |
| 17 | Calcul faux avec plusieurs sélections | SELECTEDVALUE sur sélection multiple |
Prévoir COUNTROWS/valeur par défaut |
| 18 | Colonne calculée qui explose la mémoire | Calcul stocké ligne à ligne | Calculer en amont |
16.3 Power Query et données#
| # | Symptôme | Cause | Remède |
|---|---|---|---|
| 19 | Actualisation lente | Repli cassé | Vérifier la requête native, réordonner |
| 20 | Mois et décimales inversés | Culture locale du poste | Fixer la culture explicitement |
| 21 | « Échec d'actualisation » intermittent en SaaS | Quotas d'API ou jeton expiré | Retry avec attente croissante, jeton géré, extraction hors Power Query |
| 22 | Colonne disparue après changement de source | Schéma qui dérive | Contrat de données, vue d'exposition stable, alerte |
| 23 | Doublons après actualisation incrémentale | Colonne de modification non fiable | Clé et date de modification contrôlées, partitions testées |
| 24 | Données obsolètes | Chaîne d'actualisation non synchronisée avec le chargement amont | Déclencher l'actualisation à la fin du chargement |
| 25 | Chiffres décalés d'un jour | Fuseaux horaires (UTC contre local) | Fixer une convention et la tester |
16.4 Sécurité et gouvernance#
| # | Symptôme | Cause | Remède |
|---|---|---|---|
| 26 | RLS sans effet | Test avec compte administrateur | Compte lecteur réel |
| 27 | Fuite par un autre point d'accès | Sécurité posée sur le seul modèle | Défense en profondeur par couche |
| 28 | Rapport partagé trop largement | Partage de lien sans revue | Paramètres de locataire, revue périodique |
| 29 | Contenu orphelin | Propriétaire parti | Propriétaire de groupe, inventaire |
| 30 | Données personnelles superflues | Absence de minimisation | Retirer les colonnes inutiles, masquer |
| 31 | Visuel tiers risqué | Code non audité | Visuels certifiés uniquement |
16.5 Livraison et exploitation#
| # | Symptôme | Cause | Remède |
|---|---|---|---|
| 32 | Rapports clients cassés après mise à jour | Mesure recréée, lineageTag changé |
Modifier en place, contrôle CI sur les tags |
| 33 | « Ça marche chez moi » | Environnement non paramétré | Paramètres et règles de déploiement |
| 34 | Projet qui ne s'ouvre plus | Erreur de syntaxe TMDL ou fusion | Validation syntaxique avant ouverture/commit |
| 35 | BOM ajouté sur des fichiers de modèle | Éditeur ou script inadapté | Conserver UTF-8 sans BOM pour les fichiers du projet |
| 36 | Caractères accentués corrompus | Mauvais encodage à l'écriture de scripts | Encodage explicite lors de la génération |
| 37 | Régression silencieuse | Pas de jeu de KPI figé | Tests de non-régression |
| 38 | Capacité saturée à heure fixe | Chargements et lecture simultanés | Décaler, séparer les capacités, surveiller |
| 39 | Performance différente en test et en production | Capacité et volumétrie non représentatives | Recette sur environnement comparable |
| 40 | Modèle certifié figé, on le contourne | Délais de changement trop longs | Processus d'évolution court et visible |
16.6 Conception et adoption#
| # | Symptôme | Cause | Remède |
|---|---|---|---|
| 41 | Rapport non utilisé | Pas partie des décisions | Cadrer par les décisions, prototype validé |
| 42 | Dix versions du même KPI | Pas de mesure de référence | Modèle partagé et dictionnaire |
| 43 | Page illisible sur mobile | Pas de disposition téléphone | Mise en page mobile dédiée |
| 44 | Libellés dans trois langues mêlées | Traductions incomplètes | Contrôle de complétude en CI |
| 45 | Rapport lent après ajout d'un visuel « juste un » | Accumulation | Budget de visuels par page |
| 46 | Utilisateurs exportent vers un tableur | Besoin non couvert | Analyser l'usage, offrir la vue manquante |
| 47 | Pas de support après livraison | Exploitation oubliée | Exploitation prévue dans le projet (voir 11 — checklist) |
Le piège de second ordre : traiter ce catalogue comme une liste de choses à éviter sans en tirer des contrôles automatiques. Chaque ligne qui peut être testée par un script (clés orphelines, tags disparus, traductions manquantes, isKey en double, syntaxe TMDL) doit finir en étape de pipeline.
17. Contribution de l'IA#
| Cas d'usage | Gain | Risque | Maturité | Prérequis | Garde-fous |
|---|---|---|---|---|---|
| Rédiger/expliquer du DAX | 4/5 | 3/5 | 4/5 | Modèle décrit (tables, grains) | Tester sur jeu connu ; ne pas accepter une formule non comprise |
| Générer descriptions de mesures et dictionnaire | 4/5 | 2/5 | 4/5 | Formules et définitions métier | Relecture métier ; la définition vient du métier |
| Générer traductions de libellés | 3/5 | 3/5 | 3/5 | Glossaire métier | Relecture par un locuteur natif ; complétude en CI |
| Revue de modèle (règles de bonnes pratiques) | 4/5 | 2/5 | 4/5 | Export TMDL | Complète, ne remplace pas un Best Practice Analyzer |
| Copilot dans Power BI (résumés, requêtes en langage naturel) | 3/5 | 4/5 | 3/5 | Modèle propre, descriptions, schéma linguistique ; licences/capacité adéquates (à vérifier) | Désactivable par locataire ; ne pas exposer de données sensibles ; valider les chiffres |
| Génération de scripts de contrôle (SQL, PowerShell) | 4/5 | 3/5 | 4/5 | Spécification claire | Exécution en lecture seule d'abord, relecture |
| Aide au diagnostic de performance | 3/5 | 3/5 | 3/5 | Résultats DAX Studio fournis | Valider par mesure, pas par plausibilité |
Exemples de prompts :
- « Voici la définition métier du taux de couverture et le schéma du modèle (tables, grains, relations). Écris la mesure DAX et trois cas de test avec résultat attendu. Signale toute ambiguïté de définition. »
- « Voici un diff TMDL. Liste les changements susceptibles de casser des rapports consommateurs (renommage, suppression, changement de
lineageTag). »
Ce que l'IA ne remplace pas : la définition métier d'un KPI, la responsabilité d'un chiffre publié, la décision de sécurité, ni la recette. Risques propres : formule plausible mais fausse en contexte de filtre, traduction de terme métier inexacte, génération qui recrée des mesures (donc change les lineageTag), fuite de données sensibles dans un prompt, dette cachée (modèle « généré » que personne ne comprend). Voir aussi 04 — IA (OneLake) et 08 — IA (SQL Server).
18. Voir aussi#
- Dans ce dossier : Portail du dossier · 09 — comparatif OneLake / SQL Server · 11 — checklist de projet · 01 — OneLake, vue d'ensemble · 05 — SQL Server, vue d'ensemble · 07 — SQL Server, difficultés et pièges
- Matrice Développement BI : README · modèle sémantique · mesures et DAX · sécurité RLS · versionnement et industrialisation · tests et fiabilité des chiffres · visualisation et UX
- Outils et méthodes : GDS et données SQL/BI · Git en profondeur · TFVC en profondeur · CI/CD · CI/CD pour la data
- Références : GLOSSAIRE · NOTATION · Bibliographie et ressources · IA transverse
✻ Rédigé par Claude Sonnet 5.5
