

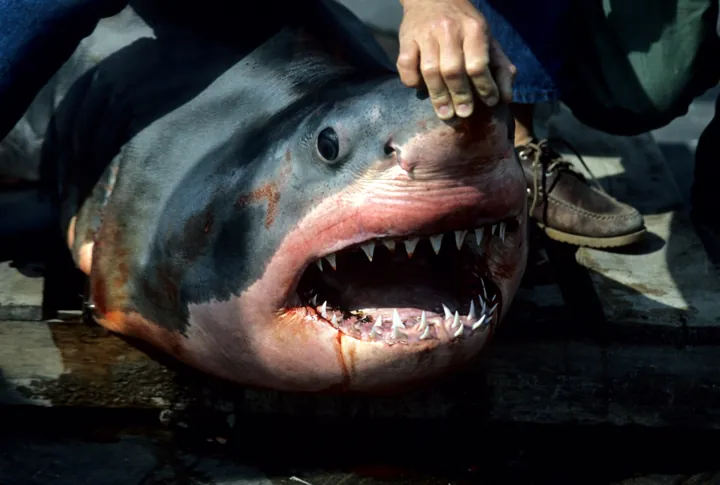
- Description
- Tête d'un grand requin blanc, gueule ouverte sur ses rangées de dents
- Source
- Dr. Dwayne Meadows, NOAA/NMFS/OPR · page d’origine
- Licence
- PD Domaine public
 Le biais de disponibilité
Ce que l'on se rappelle sans effort nous paraît fréquent ; ce qui est discret ou ancien nous paraît rare, même s'il ne l'est pas.
En bref
- Quoi : la probabilité d'un événement est jugée d'après la facilité avec laquelle des exemples viennent à l'esprit.
- Pourquoi : ce qui est récent, spectaculaire ou personnellement vécu se rappelle mieux, sans être plus fréquent.
- Détecter : les priorités suivent le dernier incident ou la dernière actualité plutôt que les données.
- Éviter : regarder les chiffres de fréquence, établir la liste des risques à froid, comparer aux cas oubliés.
Définition#
 Illustration inspirée de la personne
 Illustration fictive
 Illustration fictive
L'heuristique de disponibilité est une règle de raccourci mentale : pour estimer la fréquence ou la probabilité d'un événement, on regarde avec quelle facilité des exemples nous viennent à l'esprit. Quand les cas faciles à rappeler sont aussi les plus fréquents, la règle fonctionne. Quand la facilité tient à autre chose (récence, émotion, médiatisation, expérience personnelle), elle produit le biais de disponibilité.
Elle a été décrite par Amos Tversky et Daniel Kahneman en 1973 dans « Availability: A heuristic for judging frequency and probability », puis intégrée à leur synthèse de 1974 sur les heuristiques de jugement.
Le mécanisme#
- Substituer une question facile à une question difficile. « Quelle est la probabilité de cet incident ? » devient « puis-je m'en rappeler un ? ». La seconde se répond vite, et la réponse est prise pour la première.
- Ce qui marque se rappelle mieux. Les événements récents, spectaculaires, chargés d'émotion, ou vécus par soi-même, sont plus faciles à évoquer que des événements fréquents mais banals.
- Les médias et les récits internes choisissent. Ce qui est raconté (l'incident de production, le gros client perdu, la fuite de données dans la presse) est surreprésenté par rapport à ce qui ne l'est pas (les pannes mineures, les milliers de déploiements sans histoire).
- La facilité de l'imagination. Tversky et Kahneman notent que la probabilité est aussi jugée à la facilité avec laquelle on imagine un scénario. Un risque que l'on sait décrire en détail paraît plus probable que celui dont on n'a pas d'image.
Dans une des expériences, on demande si, dans un texte anglais, davantage de mots commencent par la lettre K ou l'ont comme troisième lettre (et de même pour R, L, N, V). Les participants répondent majoritairement « commence par », alors que ces lettres sont plus fréquentes en troisième position : il est simplement plus facile de retrouver des mots par leur initiale. Dans une autre, on lit aux participants des listes de noms de personnes, dont certains sont célèbres : ils jugent plus nombreux le sexe dont les noms sont les plus célèbres, car ces noms sont plus faciles à rappeler.
Les études de Lichtenstein, Slovic et leurs collègues (1978) ont montré le même schéma sur les causes de décès : on surestime les morts spectaculaires et très médiatisées (accidents d'avion, homicides, tornades) et on sous-estime les causes discrètes mais fréquentes (diabète, maladies cardiaques, asthme).
Ce que l'on se rappelle contre ce qui est fréquent (schéma type, illustratif)
Chargement du graphique…
Voir les données
| Fréquence réelle | Fréquence perçue | |
|---|---|---|
| Cause spectaculaire (rare) | 20 | 70 |
| Cause discrète (fréquente) | 80 | 30 |
Où on le rencontre#
En conduite de projet#
- Gestion des risques : la liste de risques reprend ceux du dernier projet, ou du dernier incident, plutôt que ceux que les données suggèrent. Le risque « classique » mais discret (démission d'une personne clé, dérive du périmètre) est oublié.
- Post-mortems : les événements récents et vifs dominent le retour d'expérience ; les premiers mois du projet sont oubliés (voir l'effet de récence).
- Priorisation de la sécurité ou des tests : après une faille médiatisée, on y consacre les efforts, au détriment de risques plus fréquents.
- Chiffrage : on estime à partir du dernier projet ressemblant que l'on a en tête, et non de la série des projets passés.
- Revue de production : « ça plante tout le temps » après deux pannes dans la semaine ; ou, à l'inverse, « on n'a jamais eu de problème » parce qu'on n'en a pas souvenir.
- Choix technologique : on retient la technologie dont on a lu des retours d'expérience récents et enthousiastes.
En management#
- Évaluation annuelle : on juge une année sur les derniers mois, ou sur l'incident marquant, plutôt que sur l'ensemble des faits.
- Recrutement : on généralise à partir d'un cas vécu (« les profils venant de telle école ne tiennent pas »).
- Décisions de ressources humaines : après une démission en chaîne, on voit un problème de rétention général ; après une longue période calme, on n'en voit plus.
- Allocation du budget : on finance la crise de l'année, pas le risque le plus probable.
Cas célèbres#
Après le 11 septembre : prendre la voiture plutôt que l'avion 2001-2002#
Biais en jeu : disponibilité (risque spectaculaire), aversion au « risque redouté ».
Ce qui s'est passé. Après les attentats, le trafic aérien aux États-Unis baisse nettement et un nombre important de voyageurs choisissent la voiture. Le psychologue Gerd Gigerenzer compare le nombre de morts sur les routes américaines avec celui des années précédentes : dans un article publié en 2004, il estime l'excès de décès sur la route du dernier trimestre 2001 à 353 (davantage que les passagers des quatre avions détournés) ; dans une étude de 2006, il chiffre à 1 595 l'excès sur les douze mois suivants. Il l'interprète comme l'effet d'un risque spectaculaire, mémorable, qui a pris le pas sur un risque banal, bien plus élevé par kilomètre : celui de la route.
Ce que cela illustre
Les images du 11 septembre rendaient le risque aérien extrêmement disponible, et le risque routier invisible. L'attribution causale reste discutée (d'autres facteurs, comme la conjoncture ou la météo, ont pu jouer : l'estimation est une inférence statistique, non une mesure directe). Retenez le mécanisme : un risque vif mobilise de l'énergie, et l'énergie manque à des risques plus probables. C'est la logique de bien des arbitrages de sécurité informatique ou de test après un incident.
Les causes de décès : ce qu'on surestime, ce qu'on oublie 1978#
Biais en jeu : disponibilité (surestimation des causes spectaculaires).
Sarah Lichtenstein, Paul Slovic, Baruch Fischhoff, Mark Layman et Barbara Combs (1978) demandent à des participants d'estimer la fréquence de nombreuses causes de décès aux États-Unis (maladies, accidents, homicides, catastrophes naturelles) et les comparent aux statistiques officielles. Les estimations suivent l'ordre réel des fréquences, mais de façon aplatie : les causes rares et spectaculaires (tornades, inondations, homicides) sont surestimées, les causes fréquentes et peu marquantes (diabète, maladies cardiaques, asthme) sous-estimées. Les auteurs relient l'écart à la couverture médiatique et à l'expérience personnelle.
Ce que cela illustre
Même avec des participants raisonnables, la mémoire des événements marquants déforme la fréquence ressentie. Une équipe qui décide de ses priorités « au ressenti » reproduit ce schéma : les incidents qui ont fait du bruit pèsent plus que les pannes silencieuses mais constantes.
Signaux de détection#
- « Je me souviens d'un cas où… » comme seul argument pour juger de la probabilité.
- Les priorités de la semaine suivent le dernier incident ou la dernière actualité.
- La liste de risques d'un nouveau projet est la copie de celle du précédent.
- Les discussions mentionnent des anecdotes personnelles ou rapportées, rarement des chiffres.
- Un risque sans exemple vécu est qualifié de « théorique ».
- Une décision de sécurité ou de test est prise juste après un incident médiatisé.
- Personne ne sait dire combien de fois un événement s'est réellement produit.
Réflexes d'évitement#
- Passer de l'anecdote au chiffre. « Combien de fois cela s'est-il produit sur les vingt-quatre derniers mois ? » Les journaux d'incidents, de tickets ou d'exploitation valent mieux que la mémoire.
- Établir la liste des risques à froid. Hors de tout incident récent, avec des participants variés et une liste de catégories à parcourir, pour ne pas partir du dernier cas vécu. Le pré-mortem aide à imaginer des scénarios qui ne sont pas disponibles spontanément.
- Chercher les cas oubliés. « Quels incidents ou quels projets nous sont arrivés avant les six derniers mois ? » Tenir un historique écrit des incidents et des décisions.
- Utiliser une classe de référence. Regardez les statistiques de projets, d'incidents ou de pannes de situations comparables, plutôt que votre expérience immédiate.
- Distinguer gravité et fréquence. Un risque vif est souvent grave ; il n'est pas pour autant probable. Évaluez les deux, séparément.
- Se méfier du « récent ». Après un incident, attendez avant de réorienter les priorités : demandez ce qu'il révèle sur l'ensemble, pas sur lui seul.
- Chiffrer les risques silencieux. Mesurez ce qui n'a pas de visage (petites pannes, retards cumulés, temps perdu), pour que cela devienne visible.
- Varier les sources. Interrogez des personnes aux expériences différentes (exploitation, support, métier), car chacun se souvient de ce qu'il a vécu.
Avec l'IA : détecter, remédier, atténuer#
L'IA est utile pour agréger un historique (journaux d'incidents, tickets, comptes rendus) et sortir des fréquences, là où la mémoire d'une équipe retient surtout les incidents marquants. Elle ne remplace pas la qualité des données ; et elle a elle-même un biais pour les exemples les plus présents dans ses données d'entraînement.
Détecter#
- Comparer la fréquence réelle des incidents d'un historique à celle que citent les équipes.
- Repérer, dans des comptes rendus, les arguments fondés sur une seule anecdote.
- Signaler les risques absents d'une liste, par rapport à des catégories standard.
Remédier#
- Produire une synthèse chiffrée de l'historique : types, fréquences, durées, tendances.
- Proposer une liste de risques par catégories, à compléter à froid.
- Rédiger les questions qui ramènent une discussion aux données.
Atténuer#
- Faire relire une liste de risques par l'IA avant la réunion, pour ajouter les oubliés.
- Demander des scénarios hors du vécu de l'équipe, pour élargir ce qui est disponible.
- Faire produire un rapport régulier de fréquences, qui rend visibles les risques silencieux.
Prompts à intégrer à vos usages#
1. Fréquences réelles à partir d'un historique. Sur un export d'incidents ou de tickets, anonymisé.
Voici l'historique des incidents ou des tickets des douze (ou vingt-quatre) derniers mois : [export].
1. Classe-les par catégorie et indique, pour chaque catégorie, le nombre, la durée cumulée de l'impact et la tendance.
2. Dis quelles catégories ont le plus pesé en temps ou en coût, et lesquelles ont fait le plus de bruit mais peu de dégâts, si les données le permettent.
3. Indique ce que les données ne permettent pas d'affirmer.
N'invente aucune valeur et signale toute hypothèse.
2. Compléter une liste de risques à froid. Avant une revue de risques, pour sortir du dernier incident.
Voici la liste des risques que notre équipe a retenus pour [projet] : [liste]. Elle a probablement été influencée par nos incidents récents.
1. Parcours ces catégories : technique, planning, périmètre, ressources humaines, fournisseurs, sécurité, exploitation, réglementaire, financement, organisation, et propose pour chacune les risques courants absents de ma liste.
2. Pour chaque risque ajouté, donne un signe précoce que l'on pourrait surveiller.
3. Signale ceux de ma liste qui semblent fondés sur un seul événement récent.
Ne donne aucune probabilité chiffrée : ce sera à l'équipe de les établir à partir de ses données.
Comment les intégrer#
- Chaque trimestre : le prompt 1 produit une synthèse chiffrée des incidents, à confronter au ressenti de l'équipe.
- Avant une revue de risques : le prompt 2 complète la liste, avant que la discussion ne parte du dernier incident.
- Après un incident marquant : comparez-le d'abord à l'historique avant de réorienter les priorités.
Précautions#
- L'IA n'a pas accès à votre réalité : elle ne connaît que ce que vous lui donnez. Un historique incomplet donne des fréquences fausses.
- Les catégories qu'elle propose sont génériques : à confronter au contexte et à vos données.
- Vérifiez tout chiffre ou toute référence qu'elle avance : ils peuvent être inventés.
- Anonymisez les exports d'incidents et ne collez pas de données confidentielles dans un outil non autorisé.
Limites#
- Se fier à ce que l'on se rappelle est souvent efficace : en environnement stable, les cas disponibles reflètent réellement les plus fréquents. Le biais apparaît quand la facilité de rappel a une autre source que la fréquence.
- Un événement vif et rare peut mériter une attention disproportionnée : la gravité compte autant que la probabilité (une perte de données, un décès). Il ne faut pas ignorer les risques graves au motif qu'ils sont rares.
- Le lien causal de Gigerenzer entre les attentats et la hausse des décès routiers est une estimation, qui a été discutée ; le mécanisme (le risque vif détourne vers un risque moindre perçu) reste, lui, bien établi.
- L'effet dépend de la manière dont on pose la question : demander des exemples avant l'estimation, ou demander d'en citer beaucoup, peut inverser le jugement (travaux de Schwarz et collègues, 1991, sur la facilité éprouvée).
Sources et vérification#
- Tversky & Kahneman (1973), « Availability: A heuristic for judging frequency and probability », Cognitive Psychology, 5(2)
- Tversky & Kahneman (1974), « Judgment under Uncertainty: Heuristics and Biases », Science
- Lichtenstein, Slovic, Fischhoff, Layman & Combs (1978), « Judged frequency of lethal events », Journal of Experimental Psychology: Human Learning and Memory, 4(6)
- Gigerenzer (2004), « Dread risk, September 11, and fatal traffic accidents », Psychological Science, 15(4)
- Gigerenzer (2006), « Out of the frying pan into the fire: Behavioral reactions to terrorist attacks », Risk Analysis, 26(2)
- Schwarz, Bless, Strack, Klumpp, Rittenauer-Schatka & Simons (1991), « Ease of retrieval as information: Another look at the availability heuristic », Journal of Personality and Social Psychology, 61(2)
- Kahneman (2011), Thinking, Fast and Slow, Farrar, Straus and Giroux (traduction française : Système 1, Système 2 : les deux vitesses de la pensée).
Voir aussi#
Se combine avec, ou renforce#
Ces biais se nourrissent l’un l’autre.
Biais voisins#
Des variantes ou des cousins : à ne pas confondre.
Contrepoids et réflexes associés#
Ce qui le neutralise.
- Les données chiffrées et l'historique (notion ou méthode, sans fiche)
- La liste de risques établie à froid (pré-mortem) (notion ou méthode, sans fiche)
- L'estimation par classe de référence
