

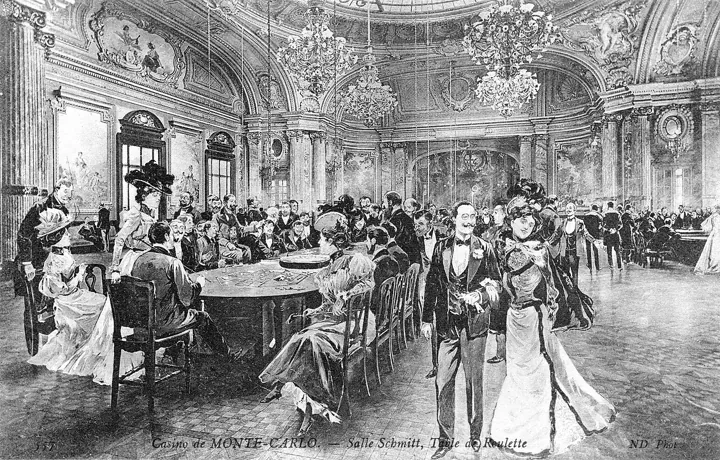
- Description
- Une table de roulette au casino de Monte-Carlo
- Source
- Neurdein Frères · page d’origine
- Licence
- PD Domaine public
 Le biais de représentativité
« Ça ressemble à » devient « c'est probablement » : la ressemblance prend la place de la statistique.
En bref
- Quoi : on estime qu'un cas appartient à une catégorie parce qu'il ressemble à l'image qu'on s'en fait, sans tenir compte du nombre de cas de chaque catégorie.
- Pourquoi : juger une ressemblance est facile et immédiat ; calculer une probabilité est lent et coûteux. Le cerveau substitue la première à la seconde.
- Détecter : « il a tout du profil » ou « ce projet est comme le précédent » sans que personne ne cite un taux ou une taille d'échantillon.
- Éviter : partir de la fréquence de base (combien de cas de chaque sorte existent), n'ajuster qu'ensuite d'après les indices, et se méfier des petits échantillons.
Définition#
 Illustration fictive
 Illustration inspirée de la personne
L'heuristique de représentativité est un raccourci de jugement décrit par Amos Tversky et Daniel Kahneman au début des années 1970 : pour savoir si un objet A appartient à une classe B, ou si un échantillon vient d'un processus donné, on regarde dans quelle mesure A ressemble à l'idée typique de B. Plus la ressemblance est forte, plus la probabilité estimée est élevée.
Le raccourci est souvent utile : ce qui ressemble à un canard est, la plupart du temps, un canard. Il devient un biais quand la ressemblance ne dit rien (ou presque) de la probabilité : ignorer la fréquence de base, juger un petit échantillon comme s'il reflétait le tout, attendre d'une suite aléatoire qu'elle « ait l'air » aléatoire, ne pas voir qu'une histoire plus détaillée est moins probable qu'une histoire plus courte.
Le mécanisme#
Le biais repose sur la substitution d'attribut : à la question difficile (« quelle est la probabilité ? ») le cerveau répond à une question facile (« est-ce que cela ressemble ? »), sans s'en apercevoir. Quatre erreurs typiques en découlent :
- Négligence de la fréquence de base : on oublie que, dans la population, la catégorie est rare ou courante.
- Insensibilité à la taille de l'échantillon : cinq cas « suffisent » pour dégager une tendance, alors qu'ils varient beaucoup par hasard.
- Erreur de conjonction : une description riche et cohérente paraît plus probable qu'une description plus simple qui la contient.
- Idées fausses sur le hasard : après une longue série de « pile », on attend « face » (l'erreur du joueur), parce qu'une séquence équilibrée ressemble davantage à ce que l'on se représente comme du hasard.
Kahneman et Tversky (1973) présentent à des participants de courtes descriptions de personnes, prétendument tirées d'un groupe de 100 ingénieurs et avocats. Dans un cas, le groupe compte 70 ingénieurs et 30 avocats ; dans l'autre, 30 ingénieurs et 70 avocats. Les participants jugent la probabilité d'être ingénieur presque de la même façon dans les deux cas : ils se fient à la ressemblance de la description avec un ingénieur type, et ignorent que la composition du groupe change du tout au tout la probabilité de départ. Quand on ne leur donne aucune description, ils utilisent correctement les proportions ; c'est la présence d'un détail, même sans valeur, qui les en détourne.
Tversky et Kahneman (1983) décrivent Linda, 31 ans, célibataire, franche, très brillante, diplômée en philosophie, préoccupée par la discrimination et la justice sociale. Puis ils demandent quelle affirmation est la plus probable : (1) Linda est caissière de banque ; (2) Linda est caissière de banque et militante du mouvement féministe. Environ 85 % des participants (étudiants sans formation en statistique) jugent la seconde plus probable. C'est logiquement impossible : l'ensemble des caissières féministes est inclus dans celui des caissières. La description « ressemble » davantage à une féministe, et ce critère l'emporte sur la logique des ensembles.
Le problème de Linda (1983)
Chargement du graphique…
Voir les données
| Réponse fautive | Réponse correcte | |
|---|---|---|
| « Caissière et féministe » jugé plus probable | 85 | - |
| « Caissière » jugé plus probable | - | 15 |
Où on le rencontre#
En conduite de projet#
- Chiffrage par analogie : « c'est comme le projet de l'an dernier » ; on retient la ressemblance de surface (même technologie, même client) et on oublie de regarder combien de projets « similaires » ont réellement tenu leurs délais.
- Diagnostic de bug : « ça ressemble au bug de la dernière fois, c'est sûrement la même cause » ; on cherche là où l'on a déjà trouvé, sans regarder la fréquence des causes possibles.
- Preuve de concept ou pilote : deux ou trois utilisateurs enthousiastes (petit échantillon) sont pris pour représentatifs de l'ensemble des utilisateurs.
- Choix d'un fournisseur : « il a la même culture que nous, il a l'air sérieux » ; le profil de l'équipe commerciale fait office de probabilité de bonne livraison.
- Lecture d'indicateurs : trois semaines sans incident sont vues comme une tendance, ou deux incidents de suite comme une « série noire », alors que le hasard produit de telles séquences.
En management#
- Recrutement et promotion : on cherche « le profil type du bon développeur » ou « du bon chef de projet » ; un candidat qui lui ressemble est jugé plus probablement bon, sans considération du taux de réussite réel des profils de ce type (voir le biais de ressemblance).
- Détection de talents : « il parle bien en comité, c'est un futur manager » ; l'aisance oratoire ressemble au leadership, sans en mesurer la probabilité.
- Évaluation d'une équipe : un mois de bons résultats suffit à classer une équipe « performante », alors que l'échantillon est trop petit pour distinguer le talent du hasard.
- Récit de carrière : un parcours détaillé et cohérent (« ancien de telle société, passionné, orienté résultats ») paraît plus probable qu'un parcours sobre, alors que chaque détail ajouté en réduit la probabilité (erreur de conjonction).
Cas célèbres#
Les 26 noirs du casino de Monte-Carlo 18 août 1913#
Biais en jeu : idées fausses sur le hasard (erreur du joueur), représentativité.
Ce qui s'est passé. Dans la nuit du 18 août 1913, au casino de Monte-Carlo, la bille s'est arrêtée sur le noir vingt-six fois de suite à une table de roulette. Selon le récit classique, les joueurs ont misé de plus en plus sur le rouge, persuadés qu'une longue série de noirs devait forcément être « compensée », et beaucoup ont perdu de très grosses sommes (on parle de millions de francs ; le chiffre exact varie selon les récits). La roulette n'a pas de mémoire : à chaque tour, la probabilité de chaque couleur était la même qu'au tour précédent.
Ce que cela illustre
Une suite de vingt-six noirs ne ressemble pas à ce qu'on attend du hasard, d'où l'impression qu'elle doit être corrigée. C'est la ressemblance qui parle, pas la probabilité. Dans un projet, la même erreur s'entend dans : « on a eu cinq déploiements ratés de suite, le prochain sera bon » ou, à l'inverse, « on a eu trois bons sprints, la vélocité est stable ». Une série courte dit peu ; ce qui compte, c'est le processus qui la produit.
Linda, le cas d'école de l'erreur de conjonction 1983#
Biais en jeu : représentativité, erreur de conjonction.
Ce qui s'est passé. Dans le test direct de Tversky et Kahneman (1983), les participants classent huit énoncés sur Linda par ordre de probabilité. La grande majorité place « caissière de banque et féministe » devant « caissière de banque ». L'erreur persiste, un peu atténuée, chez des participants plus avertis, y compris des doctorants formés aux probabilités. En revanche, quand on pose la question en fréquences (« sur 100 personnes comme Linda, combien sont caissières ? combien sont caissières et féministes ? »), l'erreur diminue nettement : ce constat sert de base aux parades de la section suivante.
Ce que cela illustre
L'histoire la plus détaillée et cohérente est séduisante, mais chaque détail ajouté la rend moins probable. En revue de risques ou en scénario d'incident, un récit précis (« la panne vient de la mise à jour réseau déclenchée par le prestataire pendant la bascule ») paraît plus crédible qu'une cause générale (« une panne réseau »), alors qu'il l'est moins.
Signaux de détection#
- « Il a tout du profil » ou « ça sent le même problème que l'autre fois », sans aucun taux, aucune proportion cités.
- Une conclusion tirée de trois, quatre ou cinq cas (utilisateurs, déploiements, candidats, sprints).
- La description d'un cas est plus longue et plus colorée que les chiffres qui l'accompagnent.
- Personne ne demande « combien y en a-t-il, en tout, de chaque sorte ? ».
- Une série (bonne ou mauvaise) est lue comme un signe de « retour à la normale » ou de « tendance » sans analyse.
Réflexes d'évitement#
- Demander la fréquence de base. Avant tout jugement : « sur les cas de ce type, quelle proportion se passe comme ça ? » Une estimation par classe de référence (les projets comparables, pas le seul projet qui ressemble) est le meilleur antidote.
- Repartir de la base, puis ajuster. Écrivez la probabilité de départ (par exemple 30 % des projets de ce genre dépassent leur délai de plus de 30 %), puis ajustez selon la force réelle des indices ; la ressemblance seule en est une faible.
- Regarder la taille de l'échantillon. « Sur combien de cas repose cette impression ? » Trois cas ne fondent pas une règle.
- Penser en fréquences naturelles. « Sur 100 projets, combien… » parle mieux à l'intuition que « 30 % de probabilité ».
- Vérifier l'inclusion. Quand un scénario paraît plus probable parce qu'il est plus précis, comparez-le à la version plus simple qui le contient : il ne peut pas la dépasser.
- Distinguer ressemblance et prédiction. Pour un recrutement, remplacez « ressemble-t-il aux bons ? » par des critères reliés à la réussite du poste (mises en situation, références vérifiées), appliqués de la même façon à tous les candidats.
- Se rappeler que le hasard produit des séries. Avant d'interpréter une suite d'événements comme une tendance, demandez si une suite de cette longueur serait surprenante par pur hasard.
Avec l'IA : détecter, remédier, atténuer#
L'IA peut rappeler la fréquence de base, faire le calcul de probabilités et poser les questions qu'on oublie. Mais les modèles de langage reproduisent eux-mêmes des erreurs de conjonction et de représentativité, et ils produisent volontiers des « statistiques » plausibles mais inventées : il faut leur demander des méthodes et des sources, et vérifier les chiffres.
Détecter#
- Repérer dans un dossier de recrutement, un compte rendu ou une analyse d'incident les jugements fondés sur la ressemblance (« profil type », « même cause que… »).
- Signaler les conclusions tirées d'un échantillon minuscule.
- Relever les scénarios trop détaillés présentés comme les plus probables.
Remédier#
- Chercher les classes de référence pertinentes et lister les données à collecter pour la fréquence de base.
- Faire le calcul bayésien d'une probabilité, étape par étape, avec vos chiffres.
- Reformuler une probabilité en fréquences naturelles (« sur 100 cas… »).
Atténuer#
- Générer des critères de sélection liés au poste, indépendants de la ressemblance.
- Faire proposer des explications concurrentes pour un incident, avec leur plausibilité relative.
- Produire un tableau de bord distinguant les séries (hasard possible) des tendances (écart durable).
Prompts à intégrer à vos usages#
1. Fréquence de base avant de juger. Quand vous êtes tenté de conclure « ça ressemble à… ».
Je suis tenté de conclure que [cas] est de type [catégorie] parce que [éléments de ressemblance].
Avant de me répondre :
1. Dis-moi quelle serait la fréquence de base à connaître pour estimer cette probabilité, et où je pourrais la trouver (sans inventer de chiffre).
2. Explique en quoi les éléments de ressemblance que je cite sont des indices faibles ou forts.
3. Propose une méthode en trois étapes pour combiner la fréquence de base et ces indices.
Si tu ne connais pas un chiffre, dis-le au lieu de l'estimer.
2. Contrôle de l'échantillon et du hasard. Quand une conclusion repose sur quelques cas ou sur une série.
Voici ce que j'observe : [description des cas ou de la série, avec leur nombre].
Dis-moi : 1) ce que ces observations permettent raisonnablement de conclure et ce qu'elles ne permettent pas ; 2) si le hasard seul pourrait produire une série de cette sorte ; 3) quelles données supplémentaires il faudrait pour distinguer une tendance d'une fluctuation ; 4) une formulation prudente de la conclusion que je peux communiquer.
3. Scénarios concurrents. Pour une analyse d'incident ou une revue de risques.
Voici le scénario que nous jugeons le plus probable : [scénario détaillé].
Décompose-le en ses hypothèses élémentaires. Pour chacune, estime qualitativement sa plausibilité, puis dis si le scénario complet peut être plus probable que sa version simplifiée. Propose trois scénarios concurrents moins détaillés et dis quelles vérifications permettraient de les départager.
Comment les intégrer#
- Chiffrage et revue de risques : le prompt 1 sert de première question quand une analogie est invoquée.
- Retour d'incident : le prompt 3 oblige à écrire des scénarios moins détaillés que celui qu'on préfère.
- Pilotage : le prompt 2 est utile avant de présenter une tendance en comité.
Précautions#
- Une IA qui vous donne une fréquence de base « de mémoire » peut se tromper ou l'inventer : exigez la source et vérifiez-la.
- Les modèles ont eux-mêmes tendance à juger plus probable la description la plus détaillée : ne leur déléguez pas la décision.
- Ne collez pas de dossiers de candidats ou d'évaluations nominatives dans un outil non autorisé ; anonymisez.
- Une IA utilisée pour trier des candidats reproduit les ressemblances présentes dans ses données : c'est un risque en soi.
Limites#
- La représentativité n'est pas toujours une erreur : quand la ressemblance est corrélée à la probabilité réelle, l'heuristique donne de bons résultats à moindre coût. Le biais commence quand elle remplace les fréquences de base.
- L'interprétation du problème de Linda a été discutée (sens du mot « probable », formulation de la question) ; les résultats varient selon la présentation, et la formulation en fréquences réduit l'erreur (Gigerenzer et Hoffrage, 1995). Le phénomène lui-même reste solidement répliqué.
- Le récit de Monte-Carlo est un classique cité de seconde main ; la date et les 26 sorties sont constantes, les montants perdus beaucoup moins.
Sources et vérification#
- Tversky & Kahneman (1974), « Judgment under Uncertainty: Heuristics and Biases », Science — représentativité, fréquence de base, taille d'échantillon.
- Kahneman & Tversky (1973), « On the psychology of prediction », Psychological Review — problème des ingénieurs et des avocats.
- Tversky & Kahneman (1983), « Extensional versus intuitive reasoning: The conjunction fallacy in probability judgment », Psychological Review — problème de Linda.
- Kahneman & Tversky (1972), « Subjective probability: A judgment of representativeness », Cognitive Psychology.
- Gigerenzer & Hoffrage (1995), « How to improve Bayesian reasoning without instruction: Frequency formats », Psychological Review — fréquences naturelles.
- Wikipédia (anglais), « Gambler's fallacy » — épisode de Monte-Carlo (1913).
- Kahneman, D. (2011), Thinking, Fast and Slow, Farrar, Straus and Giroux (en français : Système 1, système 2 : les deux vitesses de la pensée, Flammarion, 2012).
Voir aussi#
Se combine avec, ou renforce#
Ces biais se nourrissent l’un l’autre.
Biais voisins#
Des variantes ou des cousins : à ne pas confondre.
Contrepoids et réflexes associés#
Ce qui le neutralise.
- L'estimation par classe de référence
- Le raisonnement sur les fréquences naturelles (notion ou méthode, sans fiche)
